民族填「汉」还是「汉族」?GB3304 民族代码表与全称规范
在全国公务员管理信息系统里录民族,很多人卡在一个看着不像问题的地方:明明填了「汉」,报送前校核却提示民族未填写,或者批量导入后这一栏空着——数据看着填了,系统却没认。一句话结论:民族要按码表写全称「汉族」,不是简称「汉」;「土族」不是「土」,「回族」不是「回」。 系统的民族码表用的是国标 GB3304 的官方名称,你写简称它精确匹配不上,就当你没填。
下面把成因、正确写法、常用民族全称对照,以及校核提示「民族未填写」怎么办讲清楚。
一、为什么写「汉」会被判成没填
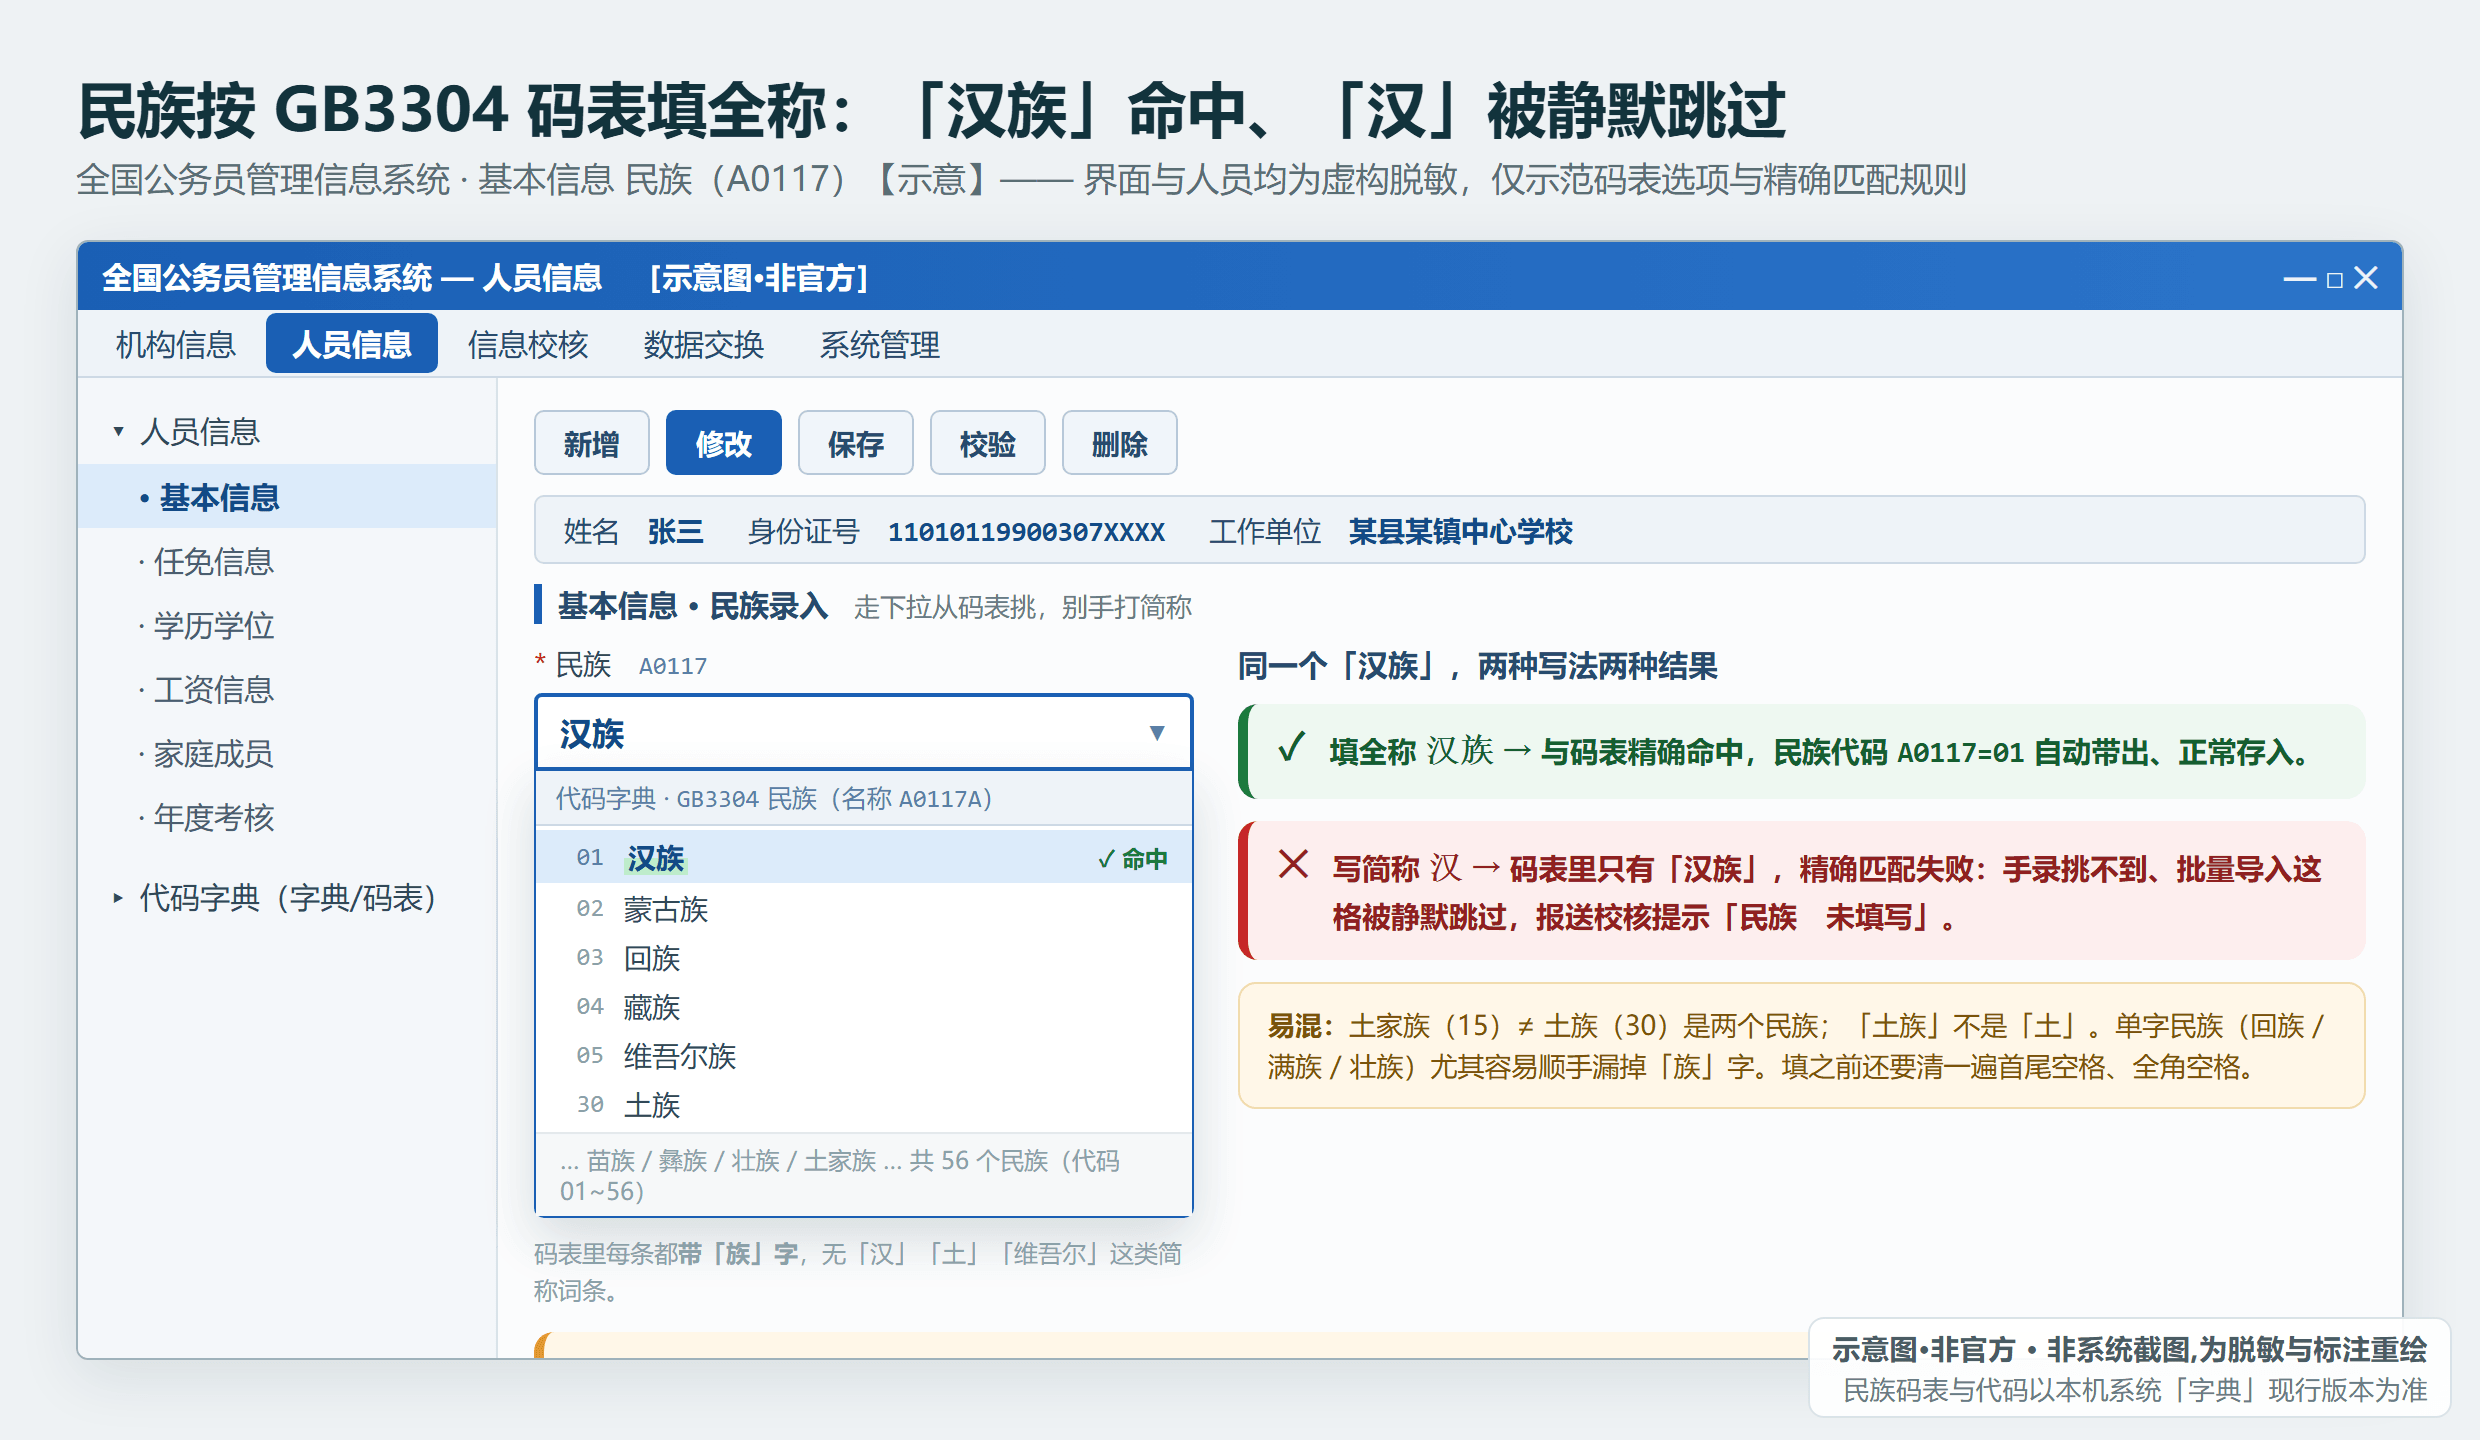
民族这一栏在系统里不是随便打字的自由文本,它对应一张代码字典(码表),标准编号是 GB3304(《中国各民族名称的罗马字母拼写法和代码》)。系统只认码表里的标准名称,而码表里存的是带「族」字的官方全称——是「汉族」不是「汉」,是「土族」不是「土」,是「维吾尔族」不是「维吾尔」。
系统匹配民族时走的是精确匹配:你填的字符串要和码表里的名称一字不差,才能对上那条码、把民族代码(系统里的 A0117)和民族名称(A0117A)一起写进去。你写「汉」,码表里只有「汉族」,精确匹配失败,结果就是这一项匹配不到码:
- 直接在系统里手录:下拉/参照里挑不到,硬打「汉」存不进,报送校核时就提示民族栏未填写。
- 批量导入:填了码表外的值,系统往往不报红,而是静默跳过这一列——你以为导成功了,细看民族栏还是空的(留空不覆盖系统原值,所以老数据不会被抹掉,但新增的人这一栏就是缺的)。
偏偏民族又是公务员系统报送前的校核必填项(和性别、政治面貌一档),缺了就过不了校核。所以「写简称→匹配不上→被跳过→校核报未填」是一条完整的坑。
二、正确写法就一条:写国标全称
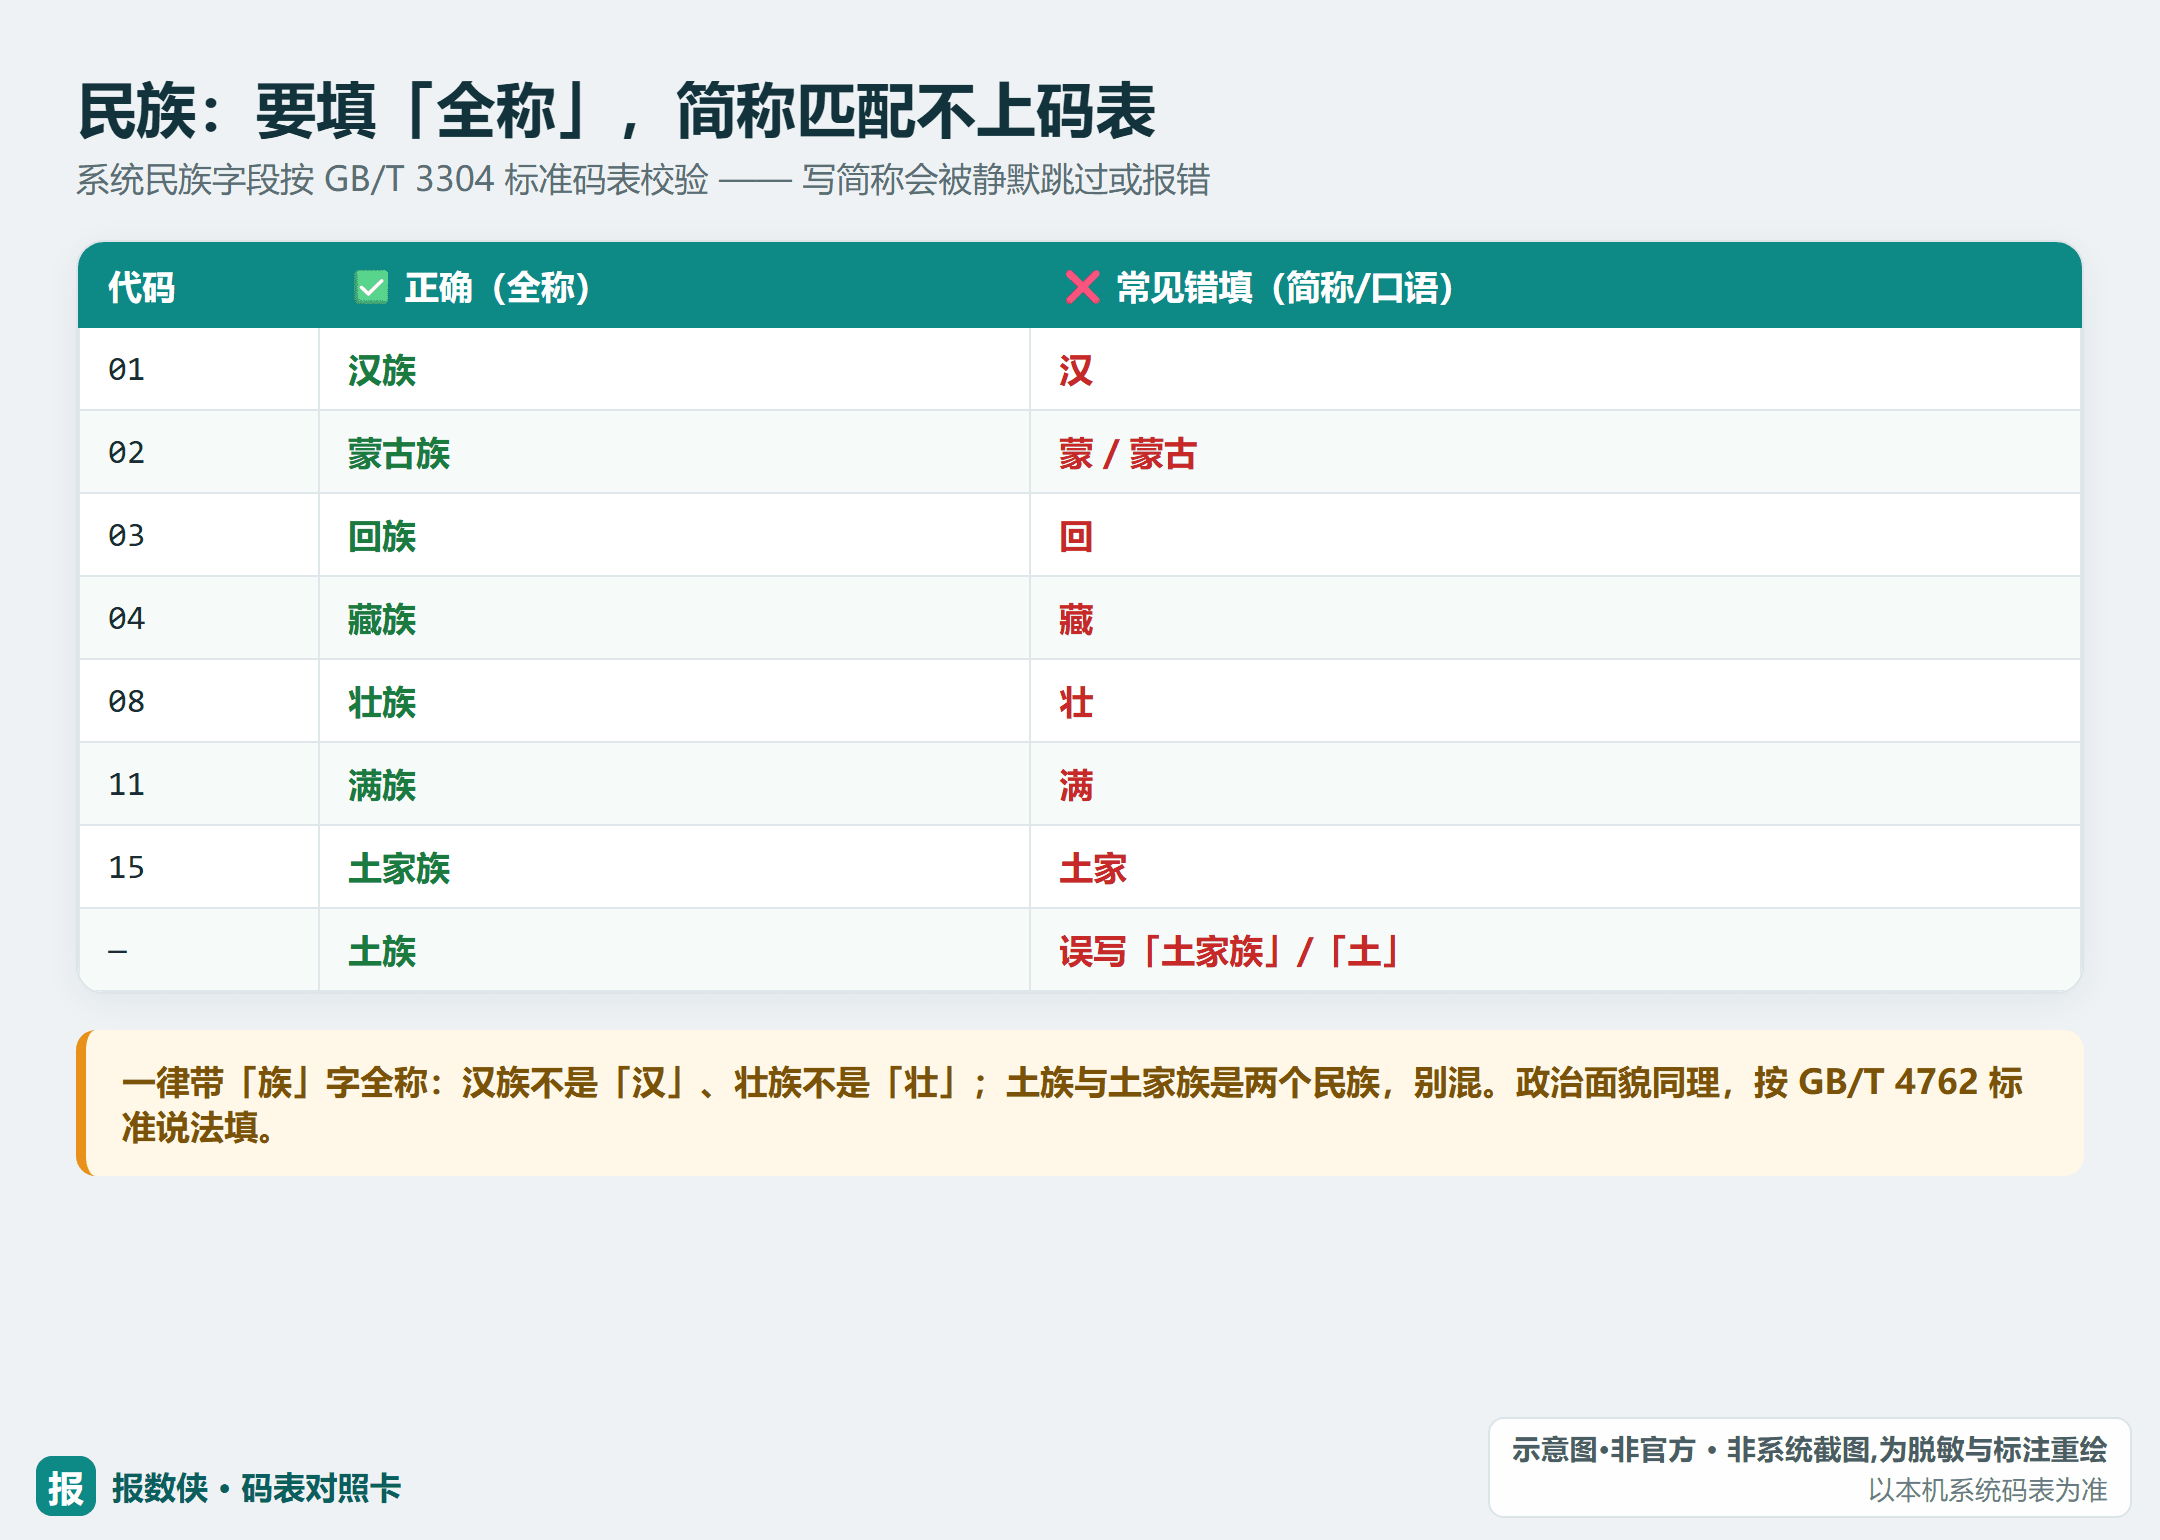
规范只有一句话:照 GB3304 码表写带「族」的官方全称。
| 你可能顺手写的 ✕ | 系统码表认的全称 ✓ |
|---|---|
| 汉 | 汉族 |
| 回 | 回族 |
| 满 | 满族 |
| 土 | 土族 |
| 蒙古 | 蒙古族 |
| 维吾尔 | 维吾尔族 |
| 壮 | 壮族 |
口诀:民族一律带「族」字,照系统码表全称写。
三、GB3304 常用民族全称与代码对照
GB3304 给 56 个民族各编了一个两位数字代码(01~56),系统里民族名称背后存的就是这个码。实操中你只要把名称的全称写对,代码由系统自动带出,一般不用自己敲。下面列常见的一部分作参照,完整码表与代码以你系统内「字典」为准:
| 代码 | 民族全称 | 代码 | 民族全称 |
|---|---|---|---|
| 01 | 汉族 | 11 | 满族 |
| 02 | 蒙古族 | 12 | 侗族 |
| 03 | 回族 | 13 | 瑶族 |
| 04 | 藏族 | 14 | 白族 |
| 05 | 维吾尔族 | 15 | 土家族 |
| 06 | 苗族 | 16 | 哈尼族 |
| 07 | 彝族 | 17 | 哈萨克族 |
| 08 | 壮族 | 18 | 傣族 |
| 09 | 布依族 | 30 | 土族 |
| 10 | 朝鲜族 | 31 | 达斡尔族 |
几个容易混的点:
- 土家族(15)≠ 土族(30):这是两个民族,别把土家族的人填成「土族」,反之亦然。
- 满族是「满族」不是「满」,回族是「回族」不是「回」——单字民族尤其容易顺手漏掉「族」字。
- 个别民族有历史旧称或别称(如德昂族旧称「崩龙族」),一律按码表现行名称写,旧称匹配不上。
四、在系统里到底怎么填
手工录入时:民族栏尽量走下拉框/参照选择,别手打。从参照里挑「汉族」,代码 A0117 会自动带出,最稳妥。如果界面允许手输,那就一字不差写全称,写完回头核一眼这栏是不是真的存下了(存不下的多半是简称或多了空格)。
批量导入时(用 Excel 模板套中间库那种):民族列直接写「汉族」「回族」这类全称即可。填之前顺手清一遍这一列的首尾空格、全角空格——「汉族 」后面跟个看不见的空格,一样会让精确匹配失败。举例占位:张三,某县某镇中心学校,民族「汉族」(示例为虚构占位,请勿填写真实公民信息)。
五、校核提示「民族 未填写」怎么排查
报送前校核弹出民族「未填写/未填」,按这三步查:
- 先看是不是真空:这个人民族栏确实没录 → 补录全称即可。
- 再看是不是简称没认:栏里像是填了、校核却说没填 → 十有八九填的是「汉」这类简称或带了空格,系统没匹配上、没真正存进代码 A0117。删掉重填全称。
- 对照码表确认名称:拿不准某个民族在系统里的准确叫法,就打开系统「字典/码表」里的民族表,照着上面的全称抄,别凭记忆写别称。
民族属于「填了码表外值 = 被静默跳过、留空 = 保留原值」的典型字段——乱填一个错值,比留空更危险(留空至少不会把系统里已有的正确民族覆盖掉)。这条「留空 vs 乱填」的铁律,和其它常见错填字段的对照,一并见常见错填对照表;学历「大学/大专」、政治面貌等其它编码字段的码表口径,见代码对照总览;校核报「未填写」的必填字段全清单与错误/提示分级,见校核提示未填写怎么办。
顺带一提
上面这些「把简称改全称、清空格、逐条对码表」的活,几百上千人逐个核对很容易漏。报数侠·公务员信息填报助手在批量导入前做了一道自检:民族这类填了码表外的值、身份证重号、单位没进名录,会在导入前的数据校验/预览里逐项标出来,让你在正式导入前就把「写成『汉』会被跳过」这种问题挑掉,少反复退回重导。它对「汉/汉族」这种只差一个「族」字的写法能自动识别补全,不过换个民族未必都有这层容错、别称旧称也认不出,所以填全称仍是最稳的。
需要说明的是:报数侠是导入前的 Excel 整理与字段校验辅助,不替代系统本身的导入流程;它在本机处理你的人员数据、不上传,联网仅用于授权激活、版本检查与支付。系统安装包仍请走官方渠道(共产党员网 12371.cn 或各省党委组织部)获取,本站不分发、不链接任何安装包。民族代码或名称拿不准时,也可以问本单位信息管理员或上级组织部门,以官方码表为准。想了解报数侠可到官网:baoshuxia.com。
【第三方声明】报数侠为独立第三方填报辅助工具,与「全国公务员管理信息系统」官方及其建设单位无任何隶属、授权或合作关系。本文示例中的姓名、单位、身份证号等均为虚构占位,请勿在实际填报中使用任何非真实数据,更不得外传真实公民个人信息。GB3304 民族代码及名称请以你系统内现行码表为准。
逐人逐字段手工录入,太耗时?
报数侠·公务员信息填报助手能把整理好的 Excel 批量导入系统、顺带做字段与单位校验,把机械的录入活省下来。工具仅帮你省手工,系统本体与权威填报口径仍以官方为准。
了解报数侠 →